热摸爽怎么把不同网站的同一条新闻合并成一个事件?
同一条新闻到了不同网站,标题常常各写各的。热摸爽怎样比较链接、标题片段、来源和数字,把重复报道归成一个事件?这篇讲清合并规则、代表标题和来源保留,也解释漏合并与误合并。
同一条新闻,到了不同网站,常常像换了几件衣服:一家写“我国首次实现……”,另一家写“中国首次实现……”,问答网站再补一句“这意味着什么?”看起来是三个标题,读者想知道的却是同一件事。
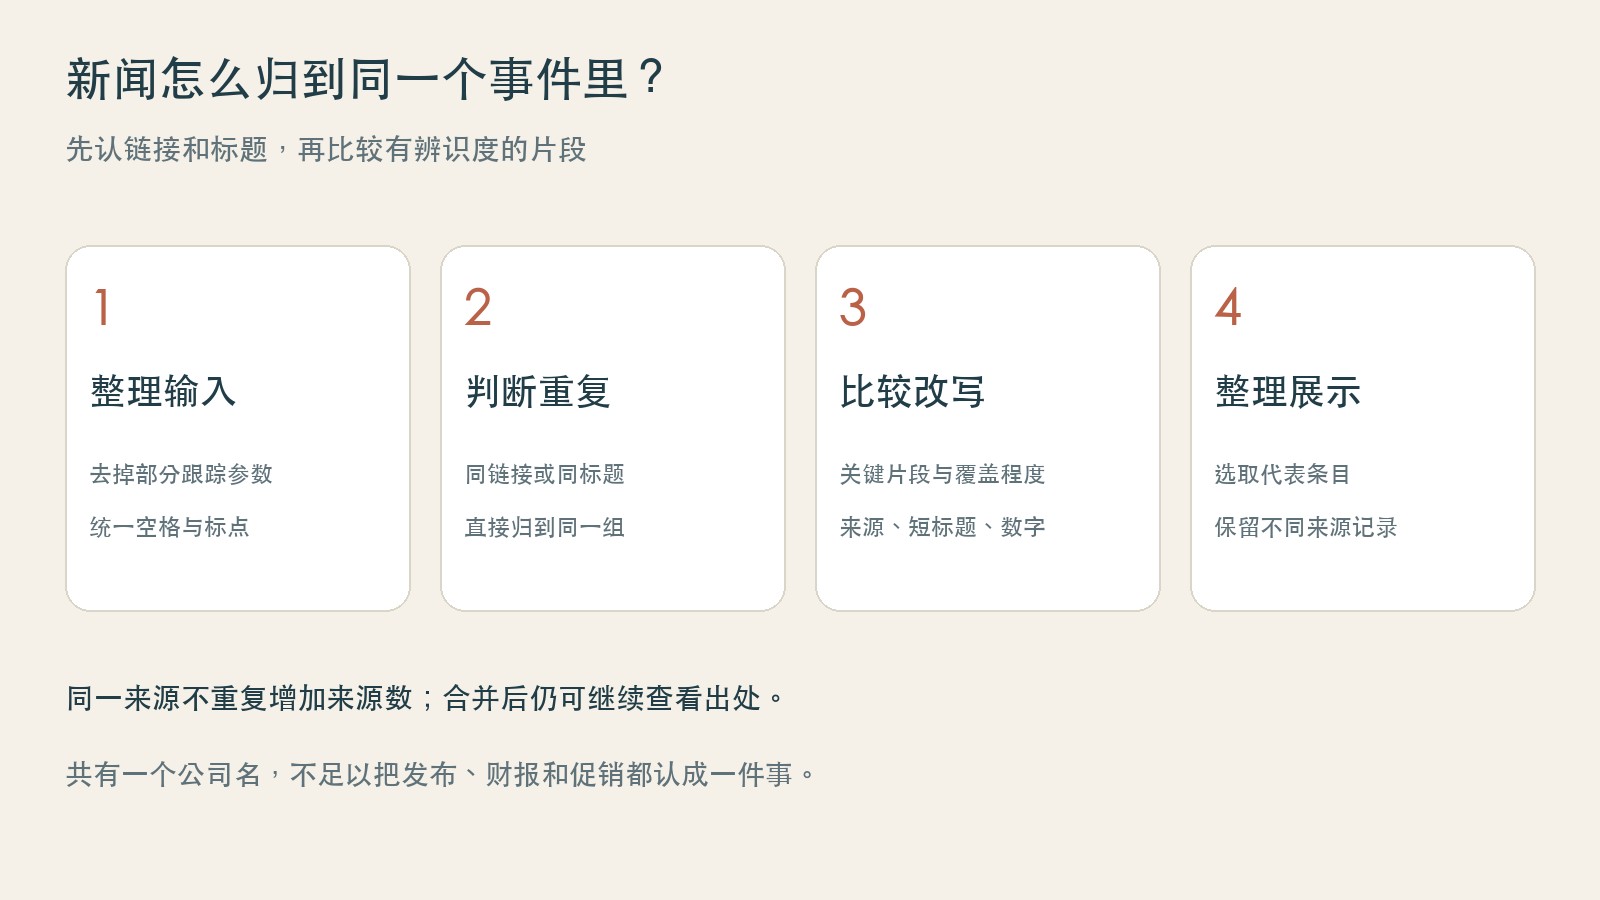
热摸爽合并新闻,先检查规范化后的链接和标题,再比较标题中有辨识度的片段,结合来源、标题长短和数字变化,把符合条件的条目归到同一组。展示时选一个代表条目,同时保留不同来源的记录。
难点不在删除两条一模一样的标题,而在认出那些换了说法的报道,又别把“同一个人最近做的所有事”打包成一件大事。一个人可以一天上三次新闻,程序不能因此替他取消另外两次活动。
先处理最容易认出的重复
第一种是链接相同。有的分享链接带着跟踪参数,实际仍指向同一篇文章。热摸爽会去掉部分常见的跟踪参数和页面片段标记,再比较地址。例如,链接末尾多了一个 utm_source,不必就当成新报道。
这一步也有取舍:不会把所有参数一股脑删掉。有些参数用来指定文章或页面内容,删完连新闻都换了,就谈不上去重了。
第二种是标题相同。程序统一英文大小写,去掉空格、标点和一些符号。标题里的逗号换成冒号,不足以让一件事重新占一个位置。规范化后完全相同、达到基本长度的标题,会直接归到一组。
同名判断很快,但也会出错。“暴雨预警”这类标题信息太少,两个地方都能用。完全同名的合并规则认的是文字相同,还不是核实过地点、时间和事实。这也是后面需要继续检查出处的原因。
标题不一样,就比较它们共同讲了什么
不同媒体很少约好用同一句话。只认完全相同的标题,会把大量改写报道漏掉。
热摸爽的基础匹配会把中文标题拆成相邻的两个字。例如“火箭回收”,会得到“火箭”“箭回”“回收”几个片段;英文和数字则按相应的字母数字片段处理。程序比较这些片段,而不是逐条调用AI阅读整篇报道。
但共有的文字不都一样有用。“中国”“发布”“最新”到处都是,辨别具体事件时,往往不如一个较少出现的人名、型号或事件用词。程序会根据当前候选中的出现频率,挑选较有辨识度的片段;过于常见的模板片段会被排除。
接着看两件事:两边共同的片段占整体多少;较短标题里的内容,有多少也出现在较长标题中。第二项尤其适合长问句与短标题的比较。问答标题多加了“如何评价”“会带来哪些影响”,不应该光因为字数变多,就与原来的消息彻底失联。
比如,假设两家分别写“中国首次实现火箭陆地回收”和“我国首次实现火箭陆地回收”。后面的关键动作高度一致,前面的称呼变化,就不该成为把它们拆开的主要理由。
不是相似就合并:来源、短标题和数字各有检查
热摸爽对同一来源的相似标题,要求更高;对不同来源的改写报道,允许更大的措辞差异。一家媒体同一天能发公司财报、产品发布和人物采访,共有一个公司名,不能全塞到同一个事件里。
所以,同来源的匹配更接近“几乎同稿异题”;跨来源的匹配则会更多考虑核心片段的重合和短标题的覆盖程度。
很短的纯中文标题也采用更高的相似度要求。拿“长安的荔枝”来说,书名、影视作品和相关讨论都能用这几个字。标题越短,提供的区分信息越少,不能只凭几个共同字就迅速点头。
数字则是另一个重要提示。两个标题都有数字,而且没有相同数字时,程序会提高部分合并路径的要求:同一模板套在不同对象上,经常就是这样露出差别的。
不过,数字变了也不一定是另一件事。一次事件的统计结果会更新,体育报道也能分别写“净胜3分”和“75比72”。基础规则对相容的比分细节有专门处理;数字不相同但其他片段高度一致的标题,也有继续合并的路径。
| 遇到的情况 | 判断时重点看什么 |
|---|---|
| 同一链接,只多了跟踪参数 | 规范化后的地址是否相同 |
| 同一报道,标点或英文大小写不同 | 规范化后的标题是否相同 |
| 不同媒体改写同一件事 | 关键片段重合,以及短标题被长标题覆盖的程度 |
| 同一来源连续发相似标题 | 采用更高要求,避免把不同内容混为一组 |
| 数字变化或标题特别短 | 额外检查,不能只看整体文字相似 |
合并以后,其他网站的报道没有凭空消失
归到同一组以后,首页需要一个条目来代表它。当前首页合并逻辑会参考原榜单名次,选取代表条目,并优先避免让聚合回退来源盖过原站条目。代表标题来自已有条目,不是在这个步骤里现写一个标题。
不同来源的记录仍会留下。这里还要分清两个数字:合进来了多少条内容,以及涉及多少个来源。同一个来源报了两条相似稿件,条目数可以增加,来源数不会因此重复增加。
归并结果也会影响后续排序,因为跨来源关注是热摸爽热度的一项依据。具体排序可以接着看热摸爽的热度是怎么算的。合并解决“是不是在讲同一件事”,排序解决“这组内容放在什么位置”,两项工作各有规则。
事件页再把相应来源整理出来,方便读者继续找出处。一件事被合并到一起,不代表几家媒体的说法已经互相证实。它们也可能都引用同一份材料;找证据,仍得点回原文。
早报会再做一轮整理,AI摘要是后面的事
早报需要在有限篇幅里讲清一段时间内发生了什么。如果同一件事因为后半句写法不同而占了三条,读者会觉得发生了三件大事,实际上只是同一条消息来了三位亲戚。
因此,早报选材在基础标题分组之外,还会比较较长的共同主语、多个少见的共同片段,以及部分情况下的发布时间间隔。它是在早报候选里补充归并,不意味着首页、来源页和早报一定排成一模一样的列表。
AI摘要在选材之后进行。不能因为后面有AI整理文字,就把前面的标题匹配也说成“AI已经读懂了所有新闻”。基础分组看的是链接、标题特征和固定规则,摘要负责另一项工作。
为什么有时该合的没合,不该合的又凑到一起?
漏合并通常是标题改写得太远,关键片段没有对上。误合并则可能来自信息太少、模板太像,或者几条相似标题接连把两个不同进展连进了同一组。
分组会把已判定相连的条目接起来:A与B符合条件,B又与C符合条件,三条就能进入同一组。这样能接住同一件事的多种改写,但中间那条若认错了,也会把错误带过去。
人类也得回原文才能判断的两个标题,程序不能只靠十几个字稳定猜中。这不妨碍合并减少重复阅读,但“放到一起了”与“已经查明是一回事”仍然要分开。
看到事件里的来源明显在说不同事情,或者同一条新闻反复占位,可以通过建议反馈把相关页面和原文链接发过来。指出具体哪两条分错了,比一句“算法不太聪明”更容易定位问题。
热摸爽做这件事,是想让你少看几遍同样的消息,多留一点时间看真正的新进展。新闻可以换标题,读者不用每换一次,就重新交一遍注意力。