把热摸爽接到你手边:RSS 订阅、iframe 嵌入与开发者接入教程
热摸爽除了看热榜还能做什么?这篇图文教程从 RSS 订阅和 OPML 导入讲起,带你把五条热点嵌入博客,再用 Python 读取 RSS、用 Markdown 获取历史快照。附可复制代码、真实截图和常见问题排查。
想知道今天大家在聊什么,通常要先打开微博,再翻知乎,顺手看一眼 GitHub。内容还没看几条,浏览器已经先开了个小型互联网大会。
热摸爽把这些公开榜单放到了一起。但它的用法不只是在首页刷一刷:你可以按领域筛热点,回看某一天的榜单,也可以把更新送进阅读器,或在自己的博客里放一块今日热点。
这篇按实际操作来写。只想订阅的,看到 RSS 那一节就够了;有网站的,复制 iframe 代码;写脚本的,后面还有一个不用安装第三方库的 Python 示例。三个入口都不需要注册热摸爽账号。
先认一下路:热摸爽能做什么?
快速扫一遍:首页综合榜把不同平台的热点混排。只关心某个领域,可以去 AI、科技或财经分类;只想看一家平台,也有微博、知乎等独立来源页。列表适合顺着看,看板适合把几家榜单并排扫过去。
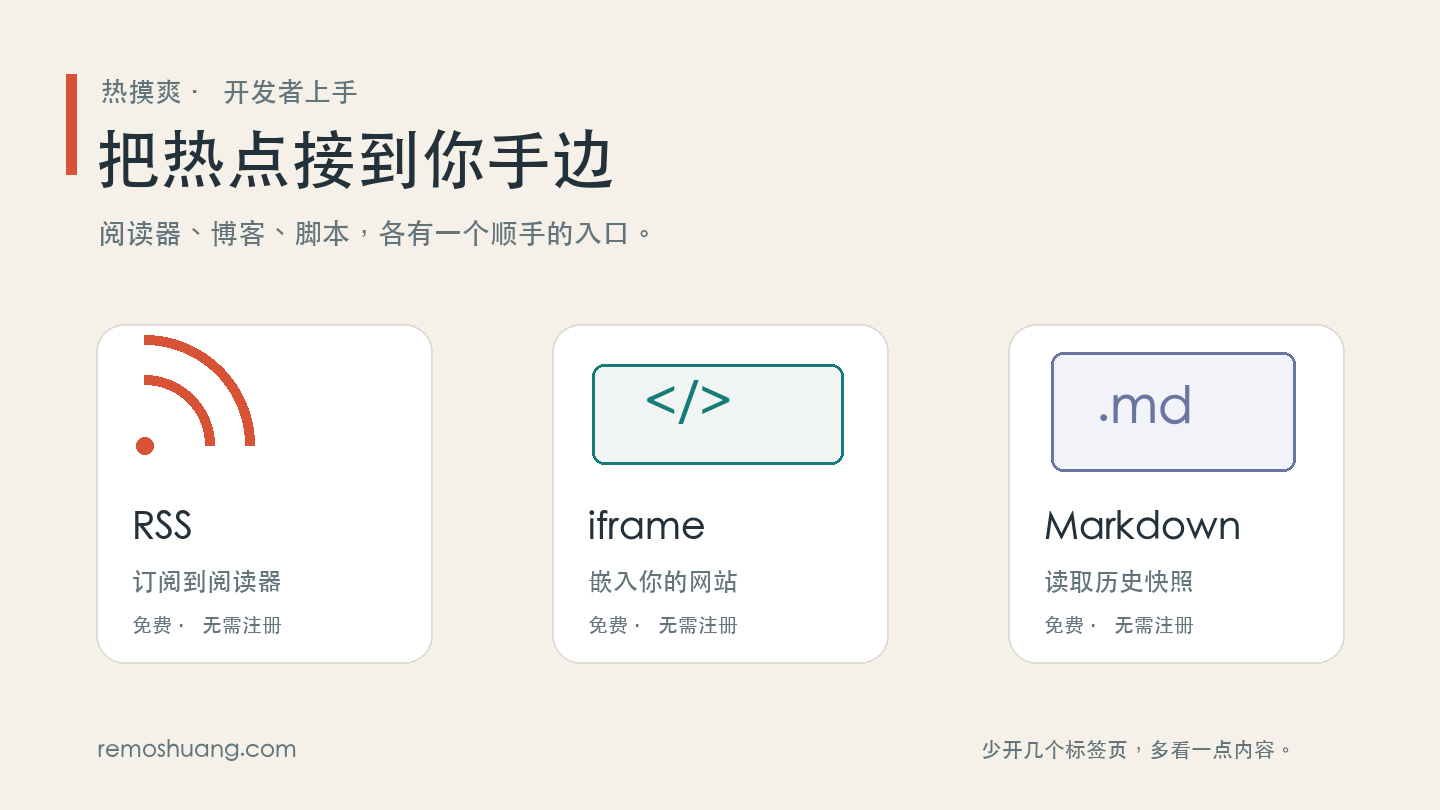
弄明白一件事怎么传开:热点事件页汇总同一件事的不同来源和传播时间线。正在升温关注的是近期增速,而不是现在的绝对名次。一个话题已经很热,和一个话题正在变热,是两回事。
补课和回查:每日早报适合集中读,历史存档适合找某一天的榜单。我更建议做回顾文章时引用存档:实时首页会变,存档才能保留当时的排名。
只盯自己关心的东西:登录后可以设置我的关注,也可以在关键词关注中填公司、产品或行业词。这和下面的 RSS 不一样:个人关注需要账号,公开订阅源不需要。
如果你要把内容带出去,选入口的标准更简单:自己读,用 RSS;给网站访客看,用 iframe;让脚本或 AI 读某一天的资料,用 Markdown。
把热点送进阅读器:RSS 怎么订阅
RSS 可以理解为网站留给阅读器的一条更新地址。你订阅一次,后面由阅读器来取新内容,不用每天惦记着打开本站。
第一次用,我建议先订综合源,或者只订你关心的一个分类。别急着把所有源都加上。同一件事可能出现在综合源和分类源里,未读数字不会因为你很忙就手下留情。
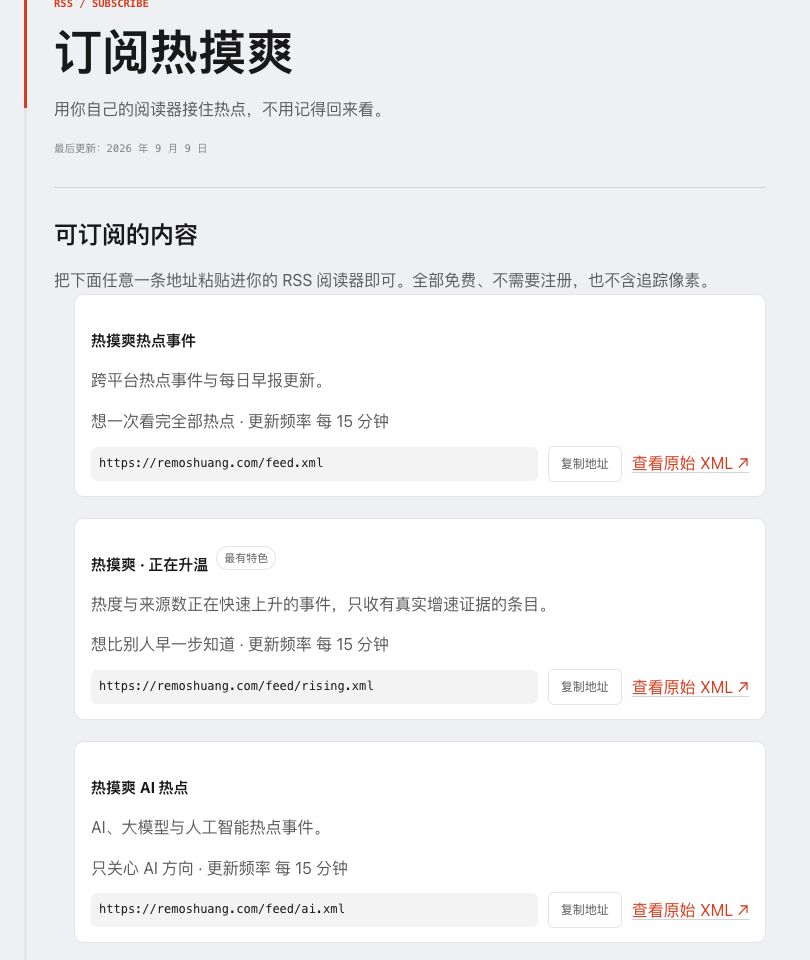
图 1:本站 RSS 页面。每个订阅卡片都给出了地址和“复制地址”按钮。
单个源,四步就能加进去
打开RSS 订阅页,选“热摸爽热点事件”或一个分类,点击“复制地址”。比如综合源是
https://remoshuang.com/feed.xml。打开你已有的 RSS 阅读器,找到“添加订阅”“添加源”或 “Add Feed”。不同阅读器的按钮名称会有差别。
粘贴刚才复制的完整地址。阅读器识别出订阅名称后,确认添加;有文件夹功能的,可以把它放进“热点”或“行业观察”。
打开这个订阅,确认能看到条目。点开一条,再用条目链接进入事件页或早报页。如果浏览器直接显示 XML 标签,也正常,那是给阅读器看的原始格式。
五个主要订阅地址在这里,按用途挑就行:
综合热点与早报:https://remoshuang.com/feed.xml
每份使用 RSS 2.0、UTF-8,最多 30 条,缓存约 15 分钟。它是近期内容窗口,不是完整历史库;想长期留档,需要自己的程序持续保存。
“正在升温”有时没有条目。这一源只收符合增速条件的事件,没符合条件的就空着。对我来说,宁可让它安静,也比拿普通热榜凑一份“正在升温”诚实。
想一次加齐,用 OPML
打开并保存 https://remoshuang.com/feeds.opml。在阅读器的设置或订阅管理里找到“导入 / Import”,选择这个 OPML 文件,再确认导入。五个主要源会一起加入。
OPML 是订阅地址清单,不是文章备份。导入完成后,阅读器还要去各个地址拉取内容。已经订过部分源的话,导入后检查一次重复项,避免同一消息在两个文件夹里重复出现。
博客侧栏缺点东西?放一个 iframe
iframe 的意思是:在你的页面里留一块位置,显示热摸爽提供的榜单组件。你不用自己写排序、卡片样式或数据抓取。组件里有热点标题、来源和热度,底部保留回站链接。
先打开开发者接入页的组件预览。把“条数”选成 Top 5,“配色”选成深色,就能看到下面这类效果。截图中的新闻和更新时间只是拍摄当时的内容,接入后显示的是组件当前返回的榜单。
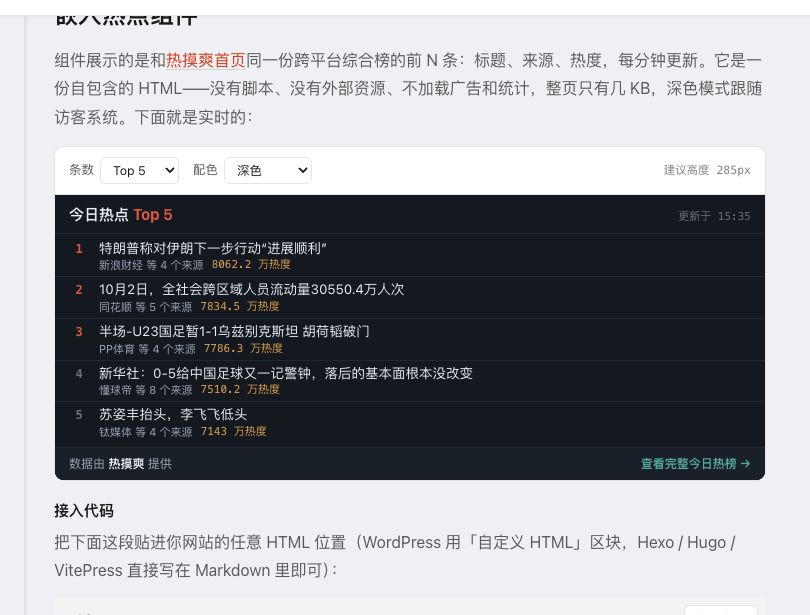
图 2:Top 5、深色配色的实际组件预览。底部来源署名和完整榜单入口也要一并保留。
用五条热点先跑通
把这段代码放进支持 HTML 的页面位置。博客侧栏用五条通常更省地方,建议高度约 285 像素:
<iframe
  src="https://remoshuang.com/embed/hot?limit=5&theme=dark"
  width="100%"
  height="285"
  loading="lazy"
  title="今日热点 · 热摸爽"
  style="border:0; border-radius:12px;"
></iframe>WordPress:在页面或文章编辑器里新增“自定义 HTML”区块,粘贴代码,先预览。确认榜单出现、底部链接能看到,再保存页面。如果是侧栏,到主题提供的侧栏或小工具位置添加相应 HTML 区块。
普通 HTML 网站:把代码放到你准备展示热点的容器里,保存文件,打开页面检查。容器宽度建议至少留 280 像素;桌面侧栏够宽,也要看看手机上的实际效果。
Markdown 博客:需要生成器允许原始 HTML。先放到一篇本地预览的文章里,确认它真的渲染成组件。如果页面只显示代码文字,检查是不是被放进了代码围栏;如果整块消失,检查生成器或编辑器是否过滤了 iframe。不同工具的配置不一样,不能指望一段代码让所有编辑器都突然通情达理。
条数、配色和高度怎么改
limit控制条数,范围 1–30,默认 10;theme可选 auto、light、dark。其中 auto跟随访客系统的深浅偏好,并不会自动读取你博客自己的主题开关。
想显示十条浅色热点,把地址改成 https://remoshuang.com/embed/hot?limit=10&theme=light,高度改成 495。开发者页给出的高度估算是 75 + 42 × 条数:五条约 285,十条约 495。这是布局参考,放进实际页面后仍要看看是否需要调整。
组件是一份自包含 HTML,没有 JavaScript,不加载外部资源、广告或统计脚本。这个取舍让接入很轻,也意味着已经打开的 iframe 不会自己定时刷新。重新加载页面会重新请求组件,返回内容还会受到浏览器约一分钟、边缘约五分钟缓存的影响。
个人站和商业站都可以免费嵌入。请让底部“数据由热摸爽提供”和“查看完整今日热榜”保持可见、可点击,不要裁切或遮住。热点标题会打开原始内容链接,回站链接也在新标签页打开。
开发者想自己排版:从 RSS 读数据
如果你的目标是做一个自己的热点列表,iframe 的样式可能不合适。可以在服务端读取 RSS,再用自己的模板展示标题和链接。这样不依赖浏览器直接跨域拉取,也便于给所有访客共用一份缓存。
先用命令确认拿到的是 XML:
curl -fL --max-time 20 https://remoshuang.com/feed.xml下面这个 Python 3 示例只用标准库。保存为 read_hot.py,在终端运行 python3 read_hot.py;它会打印前五条的标题、链接和去重标识。这里给的是最小读取示例,还不是完整的定时采集服务。
from urllib.request import Request, urlopen
import xml.etree.ElementTree as ET

url = "https://remoshuang.com/feed.xml"
request = Request(url, headers={"User-Agent": "MyHotReader/1.0"})
with urlopen(request, timeout=20) as response:
    root = ET.fromstring(response.read())

for item in root.findall("./channel/item")[:5]:
    title = item.findtext("title", default="").strip()
    link = item.findtext("link", default="").strip()
    guid = item.findtext("guid", default="").strip() or link
    print(title)
    print(link)
    print("去重标识:", guid, "\n")
做成长期任务时,我建议先按 15 分钟或更长间隔读取,保存结果,让页面从你的缓存取数据。按 guid记录已见条目,别只按标题去重:标题可能调整,链接里的统计参数也可能改变。本站的 guid使用不带统计参数的规范链接,正是为了避免这类变化让旧内容重新冒充新内容。
网络超时或解析失败时,保留上一次成功结果,稍后再试。别把“请求失败”和“合法但没有条目的 feed”当成同一种情况。正式接入还要补上异常处理、日志和存储,示例没有替你做这些。
RSS 的简介不是原文全文。二次展示时保留链接和来源,渲染字段先转义;不要把聚合摘要当作自己写的报道,也别把“热摸爽热度”写成真实阅读人数。
给脚本和 AI 一份稳定的资料
做某一天的热点回顾,用历史快照更合适。步骤是:先在历史存档找到实际存在的日期,打开该日页面,再在地址末尾加 .md。例如页面地址格式为 /hot/YYYY-MM-DD,对应 Markdown 就是 /hot/YYYY-MM-DD.md。
早报也有 /daily/YYYY-MM-DD.md。日期要替换成已发布页面的日期;没有该日页面,Markdown 也不会凭空出现。地址目录可以从 llms.txt 或 sitemap.md查,具体规则见Agent 指南。
冻结后的快照适合稳定引用,读过一次就可以保存下来。RSS 负责持续更新,Markdown 负责某一天的材料,这两个任务分开后,程序反而简单。
公开 JSON API 和 MCP 目前尚未对外开放。需要自己处理数据,先用 RSS 和 Markdown。站内页面使用的 /api/*路径不是对外接口承诺,不建议拿它们当长期依赖。
接上了,但没显示?按这个顺序查
RSS 添加失败:确认复制的是
feed.xml之类的完整订阅地址,不是/rss说明页。先用浏览器打开地址,看是否能返回 XML。RSS 没有新条目:先看是不是“正在升温”源,再考虑 feed 缓存和阅读器自己的刷新间隔。刷新按钮不是催更按钮。
iframe 空白或被删除:先单独打开组件地址。如果能显示,再查宿主编辑器是否允许 iframe;网站设置了内容安全策略时,也要确认
frame-src允许https://remoshuang.com,不用为了一个组件关闭整套策略。组件底部被挡住:增加容器高度,检查宿主是否设置了裁切。调整高度可以,遮掉来源署名不可以。
我的建议还是从最小的一步开始:订一个源,或者嵌五条热点。确认它能稳定工作,再加分类、缓存和自己的排版。让工具替你少开几页就算成功了,没必要为了看热点,先给自己开发一套新闻客户端。
本文按 2026 年 10 月 3 日可见页面及项目实现核对,配图为本站页面实拍与原创封面。接入地址和使用约定以开发者接入页、RSS 订阅页及Agent 指南为准。
关于本文数据
- 数据来源
- 2026-10-03 核对本站 developers、rss、agents 页面与 shared/embed-hot.mjs、server/utils/rss.ts 等项目实现;封面原创,正文为本站页面截图。